让本地模型,
更懂你的 Mac。
以 MLX 为执行后端的本地推理框架。连接 CLI、Python 与流式聊天 API,以 DeepInfer 方法探索调度,让每个执行周期都有据可循。
本地工作流,
可核查的执行方式。
模型是执行对象,不是框架的定义。从已验证的 9B 演示开始,复用上下文,并探索同时计入草稿、验证与恢复成本的自适应周期。
让推测预算,随执行而变。
将 DeepInfer MTPVarlen 方法接入真实执行,以接受率和完整周期成本选择下一轮草稿预算;每次决策都可由原始 C++ 参考重放核查。
把混合状态,精确接续。
同时管理注意力与循环状态。草稿被拒绝时,通过快照、恢复和已消费前缀重放继续执行;可变分支保持独立。
让已有上下文,继续发挥作用。
原生 MLX-LM LRU 与混合状态精确快照,共用限额缓存接口;经 token 核验的消息边界,为重复请求与修改末尾的请求建立复用点。
从架构设计,到真实运行。
在 M4 Pro 上运行真实 Qwen3.5-9B-8bit。已完成调度方法对应、完整 token 保持与本地上下文工作负载验证。
多个请求,
清晰可控的执行生命周期。
有界准入、逐请求状态与取消恢复已接入真实联合目标验证。联合服务使用独立的 SmolLM2 360M 目标模型与 135M 草稿模型,通过 35/35 项功能检查,覆盖并发请求、真实 token SSE 与取消后恢复。
本次检查点通过 330 项 CPU 测试与 48 项真实 Metal 测试。小模型用于工程验证;Qwen3.5-9B 仍是首要演示载体。默认服务使用 baseline,联合执行需显式开启配置入口。
把执行控制,
落实到每一步。
模型与缓存能力接入有界请求 tick;联合预算把接受率观测与成本测量连接到真实变长验证桶。独立的 Python 路径支持批量草稿调用和已审计 Dense KV 状态裁剪,并明确恢复边界。
Dense 执行检查点通过 338 项 CPU 测试与 76 项真实 Metal 测试。Dense 快路径为显式 Python 入口;默认 API 保留已验证 baseline 与独立的联合服务入口。
下一次推理,就在你的 Mac。
Apple Silicon · Python 3.12 / 3.13 · uv。用锁定版本的 9B 模型,启动内置本地 UI 与 API。
git clone --branch main --single-branch https://github.com/ZEVIN17/deepinfer-mac.git
cd deepinfer-mac
uv sync --frozen --extra mlx
uv run deepinfer-mac doctor
uv run deepinfer-mac models --download qwen3.5-9b-8bit --target-only
uv run deepinfer-mac serveDoctor 检查 Metal、Python、可用内存与磁盘。
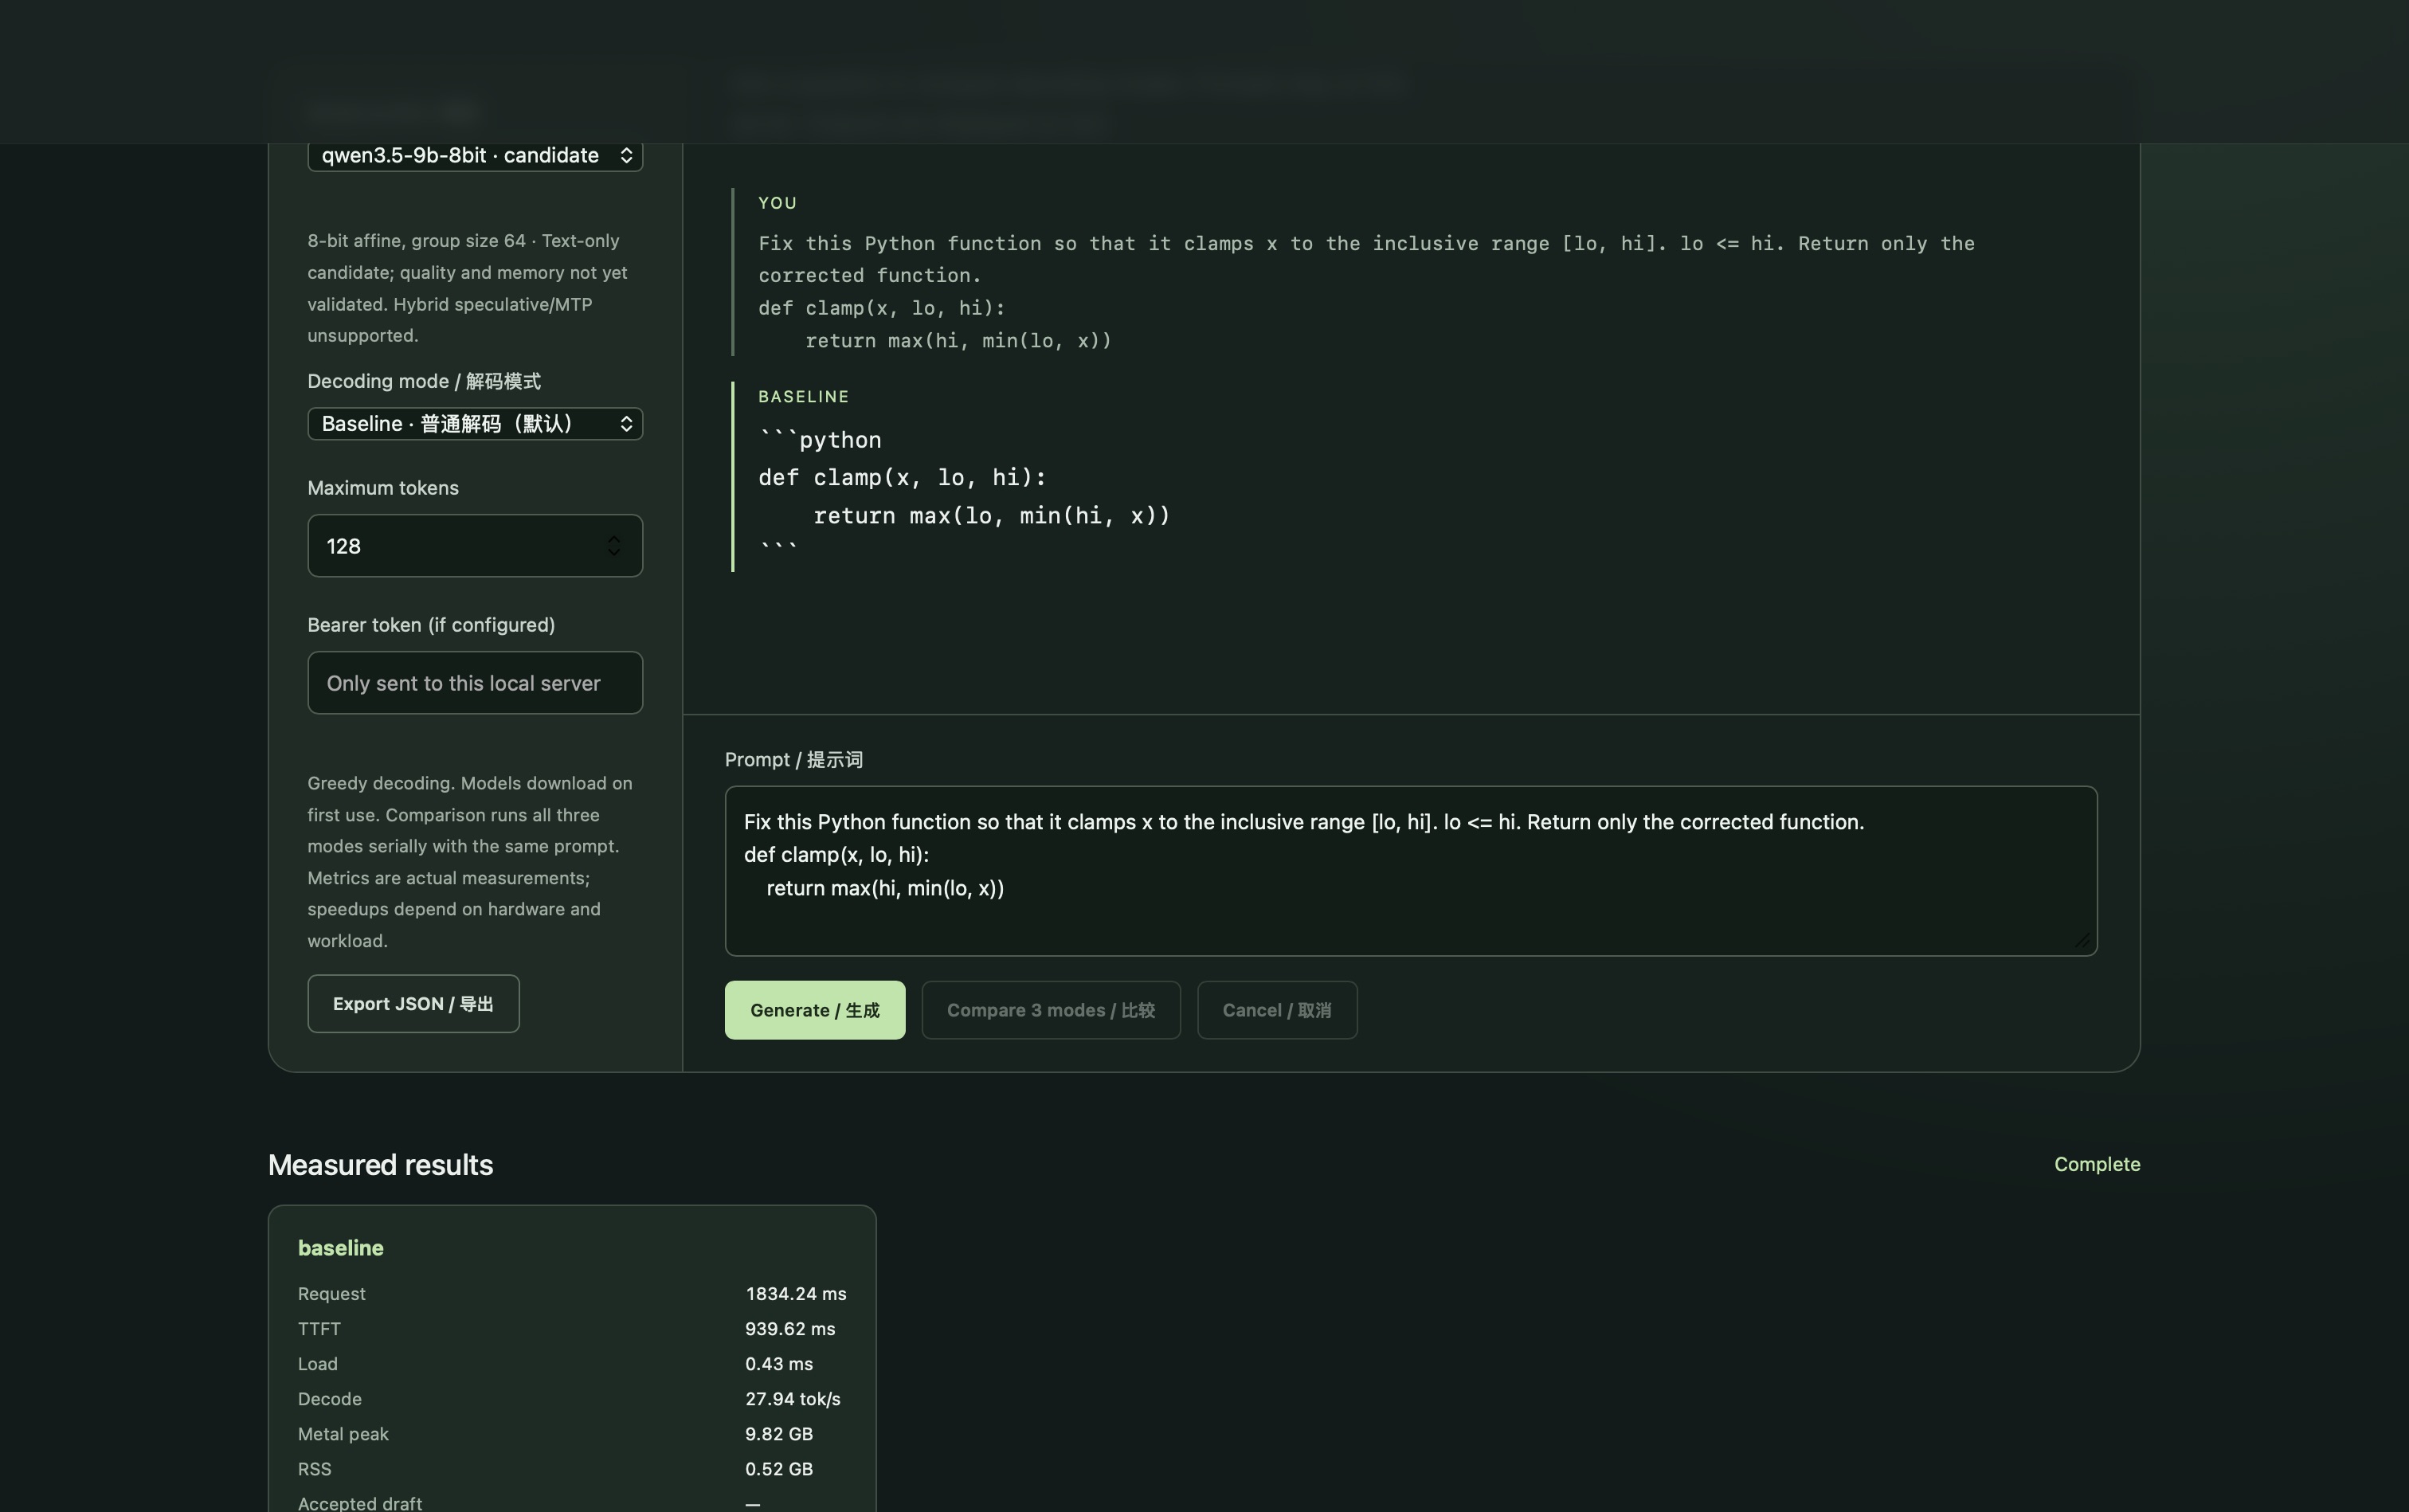
访问 http://127.0.0.1:8765,选择 qwen3.5-9b-8bit;默认使用 baseline 生成路径。
使用 CLI、流式 API 或内置浏览器 UI;自适应配置入口见架构指南。
一个框架,
清晰的能力边界。
9B 是首要演示载体。Baseline 兼容性与优化执行分别验证,按 Dense 和 Hybrid 状态结构区分能力。
| 模型 / 路径 | 状态 | 范围 |
|---|---|---|
| Qwen3.5-9B-8bit | 已验证 CLI / API / UI | Hybrid · 显式自适应 |
| Qwen3.5-9B-4bit | 已验证 baseline / native 控制 | Hybrid · 质量 / 内存对照 |
| Qwen3-14B-4bit | 已验证 baseline / native 控制 | Dense · 工程对照 |
| Qwen3-4B | 已验证回归路径 | Dense · fixed / adaptive |
| SmolLM2-135M-Instruct-8bit | 已验证 baseline / 缓存 / CLI / API / SSE | Dense · 可配置模型适配器 |
| 其它自定义模型 | 按模型独立验收 | 按能力接入模型路径 / repo |
| 联合验证服务 | 35/35 项真实模型服务检查 | 360M 目标 + 135M 草稿 · Dense 研发模型对 |
已验证仅指表中具体路径。公开 9B UI/API 使用 baseline;Hybrid 自适应需显式开启配置入口。有界多请求执行与联合验证分别提供显式配置入口;小模型联合路径已验证服务行为。
兼容性与执行模式 ↗轻量的引擎,
清晰的执行链路。
追溯方法来源,阅读实现,参与下一次改进。